NLP:形式语言与自动机

本文为《自然语言处理》课程中“形式语言与自动机”一讲的整理。
这里我们要回答的一个基本问题是:语言能否被有限条规则精确刻画?形式语言理论给出了肯定的回答——用一套重写规则(文法)就能生成一个(可能是无限的)句子集合,而有限自动机则从识别一侧给出对应的机器模型。
本讲先建立文法与推导的形式定义,再给出 Chomsky 四型分类,最后落到有限自动机与正则文法之间的等价关系。
形式语言
语言是句子集合
- 语言学视角下:“语言是人类所特有的用来表达意思、交流思想的工具,是一种特殊的社会现象,由语音、词汇和语法构成一定的系统。”(《现代汉语词典》)
- 数学视角下:“语言可以被看成一个抽象的数学系统。”(吴蔚天)
- 形式语言理论的视角下:“语言是按照一定规律构成的句子和符号串的有限或无限的集合。”(N. Chomsky)
一种语言就是一个句子集合。形式语言理论的目标,就是为这样的集合寻找精确、有限的描述手段。这套理论由 Chomsky 在 20 世纪 50 年代创立,他被视为现代语言学之父。
语言描述的途径
要描述一个语言(即一个句子集合),有三条途径:
- 穷举法:把语言中的所有句子都枚举出来。这一途径只适用于有限语言。
- 文法描述:用一组规则生成语言中合格的句子。它能用有限规则刻画无限语言,是形式语言理论的核心。
- 自动机:对输入的句子进行校验,区别哪些是语言中的句子、哪些不是。
三个动词——枚举、生成、检验——分别概括了三条途径的动作,也勾勒出“文法(生成)”与“自动机(检验)”这一对互补的工具:同一类语言,既可以用文法从内部生成,也可以用自动机从外部识别。
形式语言与产生式
形式语言是用来精确地描述语言(包括人工语言和自然语言)及其结构的手段,因与代数方法密切相关,形式语言学也称代数语言学。其基本表示形式是重写规则(rewriting rule):
其中
从一个初始字符串出发,不断运用重写规则,就能得到新的字符串;而选择不同的规则、以不同的顺序加以运用,就能得到不同的新字符串。重写规则又叫产生式(production):它“产生”出新的字符串。一个语言,正是由所有能够从初始符号出发、经有限步重写得到的合法字符串构成的。
形式语法
四元组定义
形式语法(形式文法)是一个四元组
其中:
是非终结符的有限集合,也叫变量集或句法种类集; 是终结符的有限集合,规定: - 终结符与非终结符没有交集,即
- 终结符与非终结符的并集
- 终结符与非终结符没有交集,即
是一组重写规则的有限集合 、 是由 中元素构成的串,但 至少应含一个非终结符;
举例来说,
就是这样一个文法:
推导
设
它的含义是,如果
也就是说,只要当前串中含有某条产生式的左部
(按非平凡方式派生)表示 的传递闭包,即经过 - $\overset{}{\Rightarrow}
\Rightarrow$ 的*自反传递闭包,即经过
一句话概括:+ 和 * 的功能有点类似)若上下文已明确是哪个文法,记号下标中的
最左推导与最右推导
同一个句子往往存在多种推导顺序。若约定每步只改写最左边的那个非终结符,这种推导称为最左推导;若约定每步只改写最右边的那个非终结符,则称为最右推导。最右推导也称规范推导。
考虑文法
字符串
其最右推导(规范推导)为
两种推导的每一步都合法,最终得到同一个句子。最右推导在编译原理中格外重要,因为它是自底向上语法分析的基础。
句型与句子
最后给出句型的递归定义。一个符号串可被称为文法
是一个句子形式; - 如果
是一个句子形式,且 中的产生式,则 也是一个句子形式。
句型是推导过程中出现的任意符号串,可以含有非终结符。而不含非终结符的句型,称为
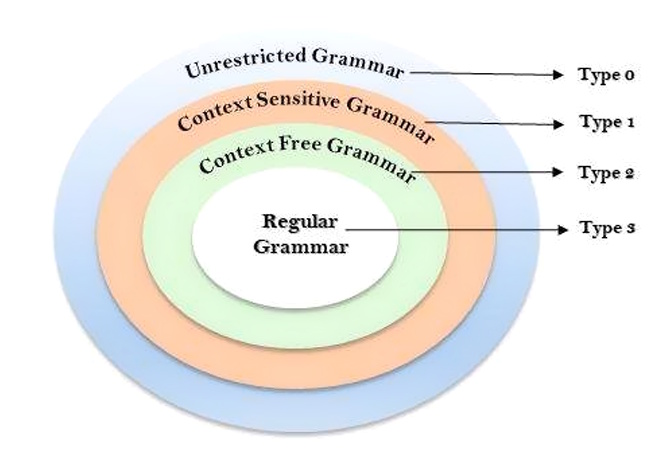
Chomsky 文法分类
四型文法对照
按产生式形式的限制从严格到宽松,Chomsky 把文法分为四型:
| 类型 | 名称 | 产生式形式 | 主要特点 | 典型语言 |
|---|---|---|---|---|
| 3 型 | 正则文法 | 产生式限制最严格,结构简单 | 正则语言 | |
| 2 型 | 上下文无关文法 | 左部只有一个非终结符,改写不依赖上下文 | 上下文无关语言 | |
| 1 型 | 上下文有关文法 | 非终结符的改写受上下文影响,通常不缩短串长 | 上下文有关语言 | |
| 0 型 | 无限制文法 | 对产生式限制最少,表达能力最强 | 递归可枚举语言 |
四型之间是严格的包含关系:正则语言
限制越严格,能描述的语言就越少,但对应的识别机器也越简单。
正则文法(3 型)
如果文法
则称该文法为正则文法(regular grammar, RG)或 3 型文法,且具体称为左线性正则文法(非终结符在终结符左边)。若规则形如
例如以下文法生成“至少一个
其中产生式
上下文无关文法(2 型)
如果
则称该文法为上下文无关文法(context-free grammar, CFG)或 2 型文法。其特点是产生式左部只有一个非终结符,因此无论该非终结符出现在什么上下文中,都可以独立地被改写——这正是“上下文无关”的含义。CFG 是描述自然语言句法、以及程序设计语言语法的核心模型。
例如
生成的语言为
上下文有关文法(1 型)
如果
且
例如:
产生式
无限制文法(0 型)
如果
语言类型的约定
一个语言可能同时能被多种类型的文法生成,此时如何判定它的类型?约定是:语言的类型取决于能够生成该语言的文法中,类型最低(限制最严格)的那一种。
例如,等数量的
上下文无关文法与派生树
派生树
CFG 生成句子的过程可以画成一棵树,称为派生树(也称分析树)。它由如下规则构成:
- 对每个
作为根节点; - 若某节点标记为
且至少有一个除自身以外的后裔,则 - 若某节点标记为
,其 ,则 中的一条产生式。
例如对
句子
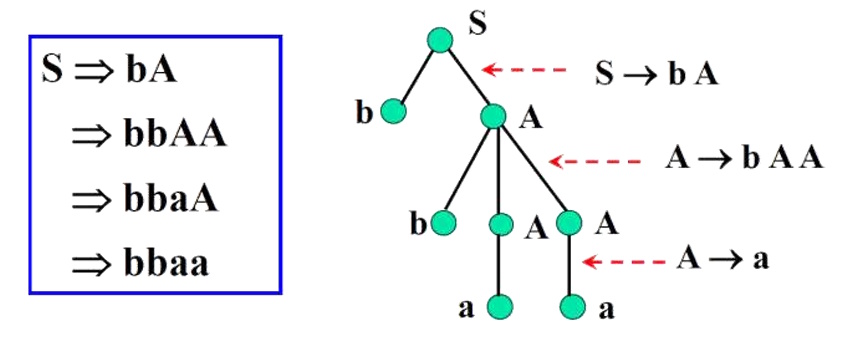
树中每个内部节点对应一次产生式的应用,叶节点从左到右的标记串就是所生成的句子。
二义性
一个文法
对句子
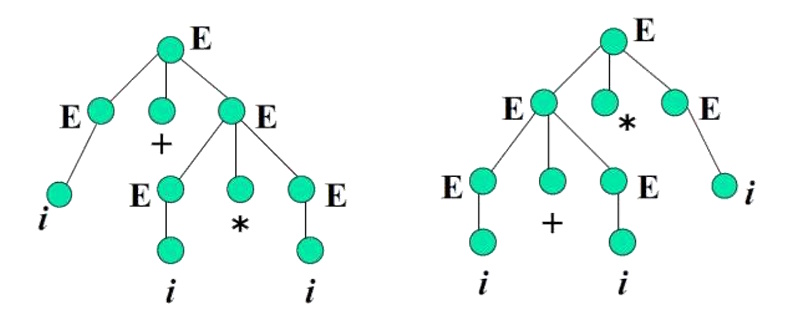
一棵把乘法留到更深处、对应先算
自然语言中的结构歧义
二义性在自然语言中表现为结构歧义。以下文法
对短语「关于鲁迅的文章」给出两种推导,因而有两棵派生树:
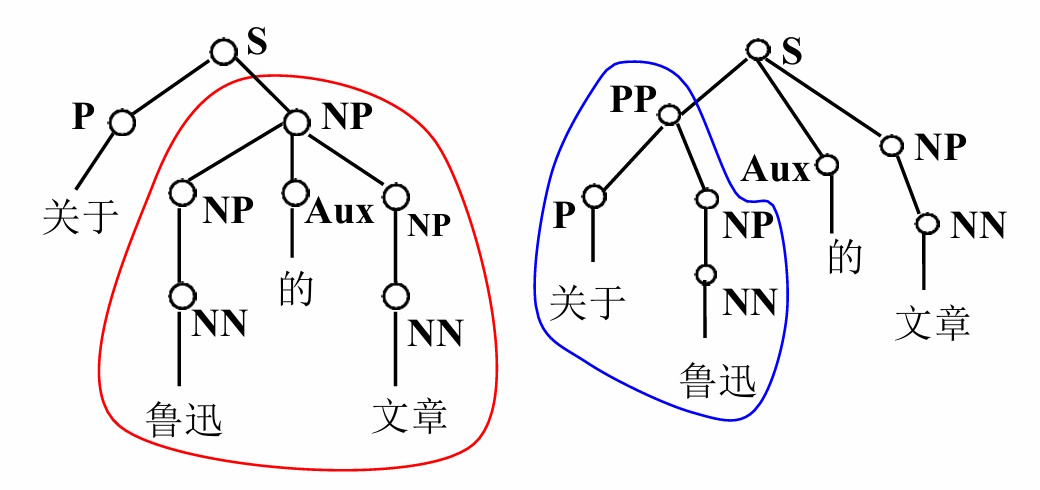
- 一棵以
- 另一棵以
同一串汉字因句法结构不同而产生两种解释,这正是句法分析需要消解的歧义。它说明自然语言也并不“上下文无关”得那么彻底——语义与上下文常常是消歧的关键。
有限自动机
从识别一侧看,最基本的一类机器是有限自动机(finite automata, FA),它分为确定与非确定两种。
确定有限自动机(DFA)
确定有限自动机
其中
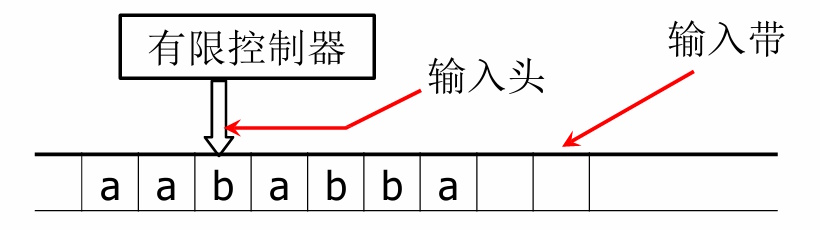
它的工作方式是:有限控制器从左到右依次从输入带上读入字符,初始时处于
DFA 定义的语言
如果一个句子
例如,下面的 DFA 接受“含偶数个
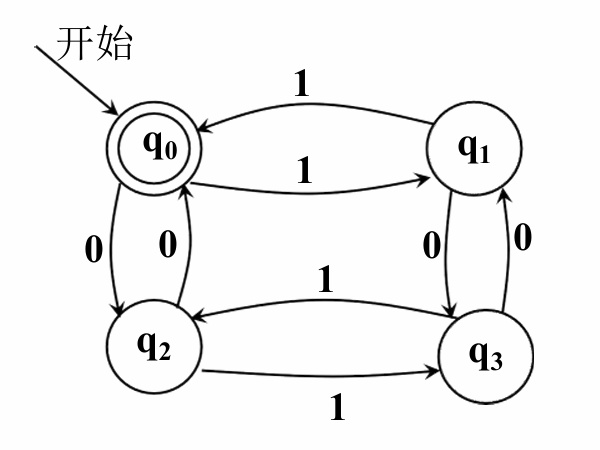
它的四个状态分别记录
不确定有限自动机(NFA)
不确定有限自动机(non-definite automata, NFA)同样是五元组
即
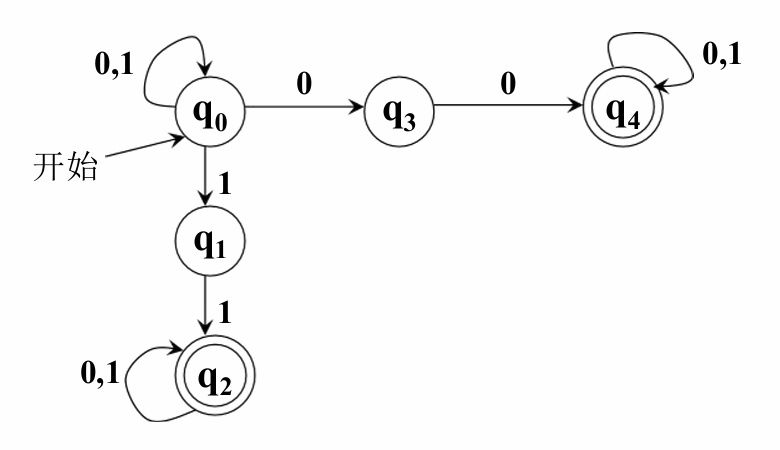
NFA 在描述上更灵活,但识别能力并不更强:任何一个被 NFA 接受的语言,都存在一个 DFA 接受它(可用数学归纳法证明)。由于二者接受的链集相同,一般情况下无需区分它们,统称为有限自动机。
正则文法与有限自动机的等价
由文法构造自动机
正则文法与有限自动机之间也有着直接对应:若
| 正则文法 | 有限自动机 |
|---|---|
| 将 |
|
| 开始符号 |
|
| 非终结符 |
对应状态 |
可以概括为一句话:非终结符变状态,终结符变边,开始符定初态,结束产生式定终态。
一个例子
给定正则文法
先取
| 映射 | 取值 | 依据 |
|---|---|---|
| 无 | ||
| 无 | ||
| 无 |
其中
这样,正则文法、正则语言与有限自动机三者就统一在了同一个框架之下——这也是形式语言理论对自然语言处理最基础的一点启示:语言、生成语言的规则、识别语言的机器,是同一件事的三种表述。
- 标题: NLP:形式语言与自动机
- 作者: Harry Huang
- 创建于 : 2026-09-18 21:05:00
- 更新于 : 2026-09-18 21:05:00
- 链接: https://blog.harryh.cn/AI/NLP-Formal-Languages-And-Automata/
- 版权声明: 本文章采用 CC BY-NC-SA 4.0 进行许可。